
ディフュージョンモデル vs GAN:主要な違いを解説
AI画像生成技術の二大巨頭、ディフュージョンモデルとGANの基本的な違いを探り、その出力を検出する方法について解説します。
AI画像生成技術の紹介
人工知能はデジタル画像の世界に革命をもたらし、簡単なテキストプロンプトから非常にリアルな画像を生成できるようになりました。この変革を支える二大技術が、敵対的生成ネットワーク(GAN)とディフュージョンモデルです。どちらも驚くべきAI生成コンテンツを作り出すことができますが、その動作原理は根本的に異なります。コンテンツ検証、ジャーナリズム、デジタルメディアの専門家にとって、これらの違いを理解することは、Detect AI Imageのようなツールを使って画像の真偽を確認する上で非常に重要です。
この記事では、ディフュージョンモデルとGANの主な違い、それぞれの強みと限界、そしてAI生成画像を検出するための実践的な知見について解説します。
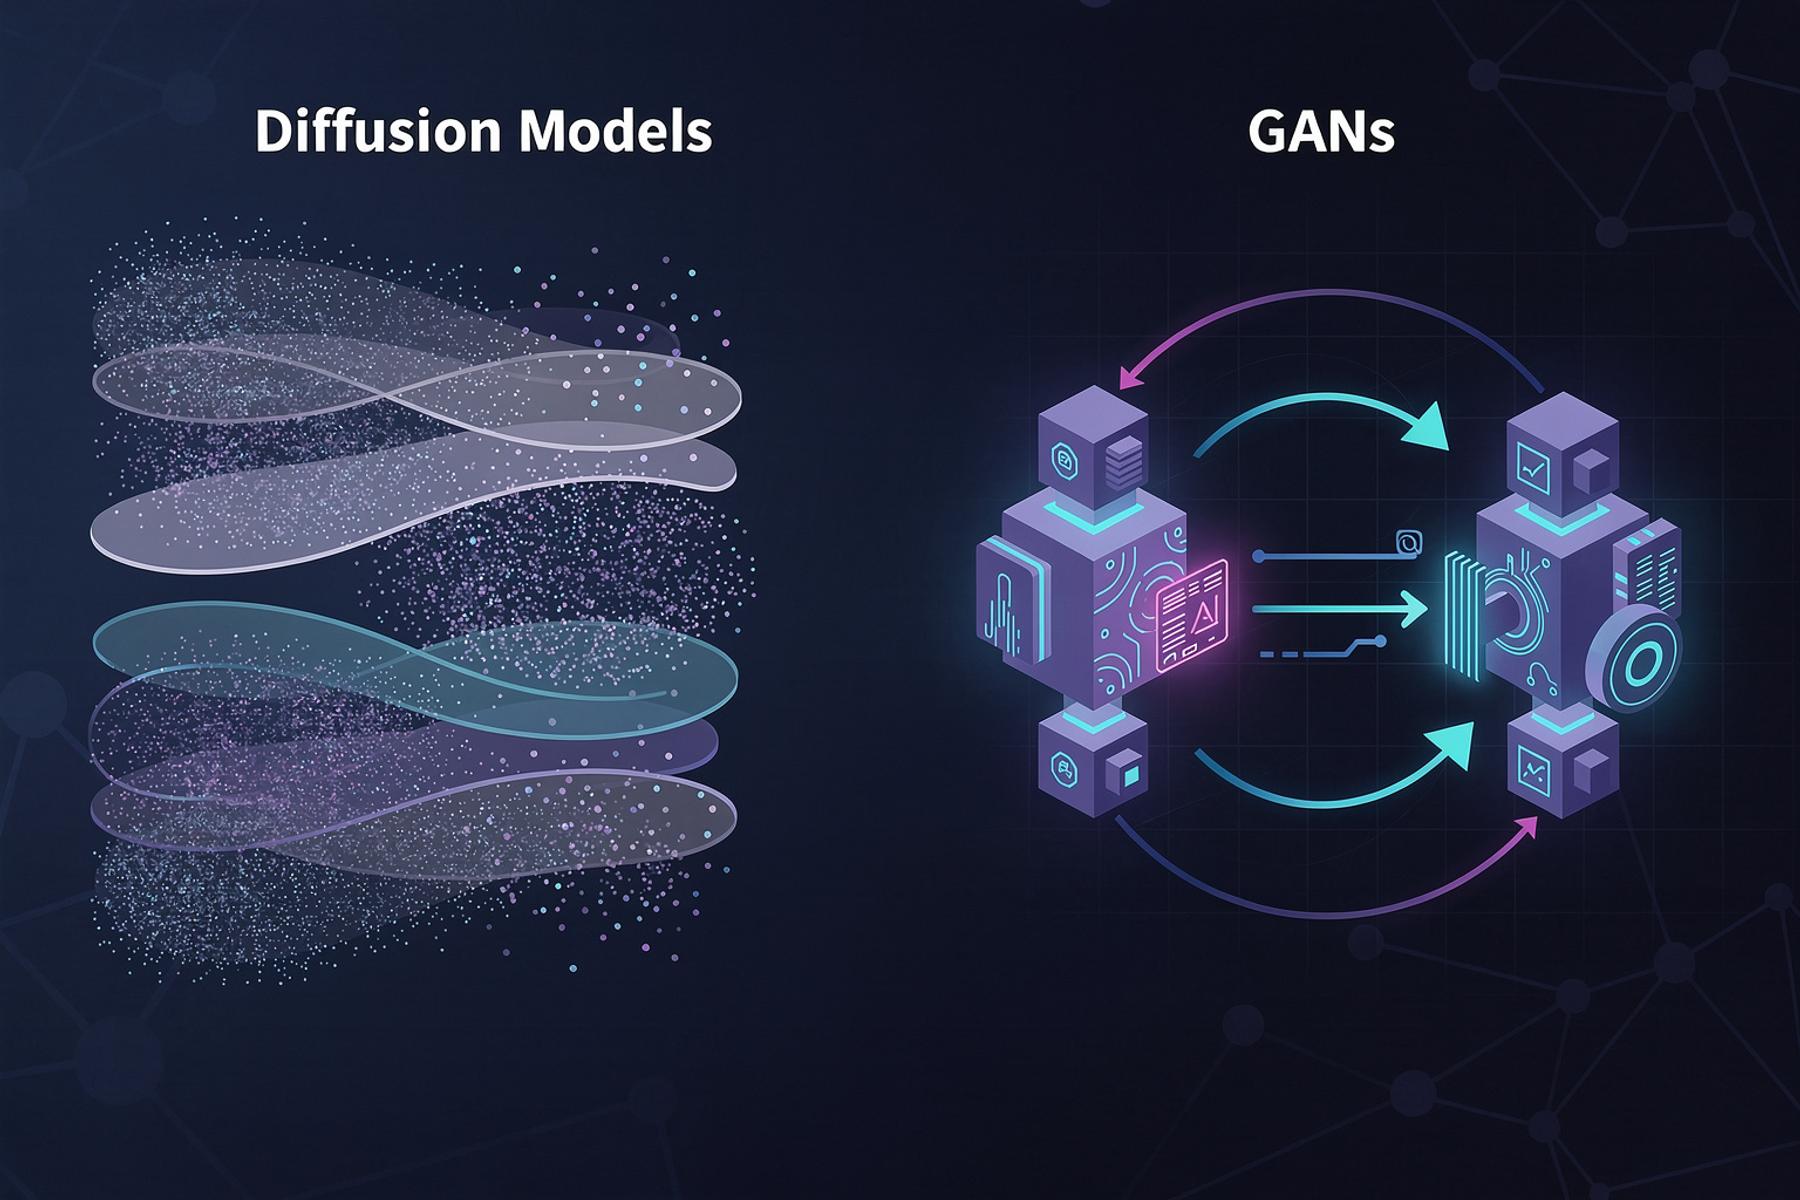
GANの仕組み:敵対的アプローチ
敵対的生成ネットワーク(GAN)は、2014年にイアン・グッドフェローによって提唱され、競い合う2つのニューラルネットワークで構成されています。
- 生成器(Generator):ランダムノイズから画像を生成し、リアルな出力を目指します
- 識別器(Discriminator):画像を評価し、本物と生成されたものを見分けます
GANの主な特徴
- 敵対的学習:生成器は識別器を騙すことで改善し、識別器は検出能力を向上させます
- 高速生成:学習後、GANは一度のフォワードパスで画像を生成できます
- モード崩壊:出力の多様性が限られ、「識別器を騙しやすい」安全な例に偏ることがあります
- 学習の不安定性:生成器と識別器のバランスを慎重に調整する必要があります
GANの実用例
- StyleGAN:非常にリアルな人間の顔を生成(例:ThisPersonDoesNotExist.com)
- CycleGAN:画像を異なるドメイン間で変換(例:馬をシマウマに変換)
- Pix2Pix:スケッチをフォトリアルな画像に変換
GANで生成された画像には、以下のような微妙なアーティファクトが見られることがあります。
- 背景の不自然なテクスチャ
- 顔の非対称な特徴
- 細部のぼやけや歪み
ディフュージョンモデル:段階的なノイズ除去プロセス
ディフュージョンモデルは、2020年から2021年にかけてOpenAIやGoogleの研究によって普及した、全く異なるアプローチを取ります。
- フォワードプロセス:画像に徐々にノイズを加え、完全なランダムノイズにします
- リバースプロセス:ニューラルネットワークがこのノイズの追加を逆転させ、ノイズから画像を再構築することを学習します
ディフュージョンモデルの主な特徴
- 反復的生成:多くの小さなノイズ除去ステップ(通常25~1000回)を経て画像を生成します
- 安定した学習:GANよりも予測可能で、モード崩壊のリスクが低い
- 高品質な出力:より詳細で多様な画像を生成することが多い
- 計算負荷が高い:学習と生成の両方で多くのリソースを必要とします
ディフュージョンモデルの実用例
- Stable Diffusion:多様な画像タイプを生成できるオープンソースモデル
- DALL-E 2:OpenAIのテキストから画像を生成するモデル
- Imagen:Googleのテキストから画像を生成するディフュージョンモデル
ディフュージョンモデルの出力には、以下のような特徴が見られることがあります。
- 一部の領域が過度に滑らかに見える
- 拡大すると細部に不整合が生じる
- 複雑な構図にアーティファクトが現れる
ディフュージョンモデルとGANの主な違い
| 特徴 | ディフュージョンモデル | GAN |
|---|---|---|
| 学習アプローチ | 段階的なノイズ除去プロセス | 敵対的競争 |
| 生成速度 | 遅い(多くの反復ステップ) | 速い(一度のフォワードパス) |
| 学習の安定性 | 安定しており予測可能 | 不安定でバランス調整が必要 |
| 出力品質 | 一般的に高品質で多様性が高い | 高品質も可能だがアーティファクトが発生しやすい |
| リソース使用量 | 計算負荷が高い | リソース使用量が少ない |
| モードカバレッジ | 多様な出力をカバーしやすい | モード崩壊が発生しやすい |
| 柔軟性 | 新しいタスクに適応しやすい | アーキテクチャの調整が必要 |
異なるモデルによるAI生成画像の検出
AI画像生成技術が進化するにつれ、本物と合成コンテンツを見分けることがますます難しくなっています。しかし、それぞれのモデルは独自の痕跡を残すため、Detect AI Imageのようなツールで特定することが可能です。
GANの検出特性
- テクスチャの不整合:背景や表面に不自然なパターン
- 顔の非対称性:目、耳、顔の特徴に微妙な不一致
- アーティファクトパターン:繰り返しパターンやぼやけた領域
- 色の分布:不自然な色のグラデーションや彩度
ディフュージョンモデルの検出特性
- 過度な滑らかさ:一部の領域がプラスチックのように滑らかすぎる
- 細部の不整合:細部が完全に一致しない
- 構図の問題:複雑なシーンに論理的な不整合
- 照明のアーティファクト:不自然な影や反射
実践的な検出のヒント
- 細部を確認:テクスチャ、髪の毛、布地のパターンを拡大して見る
- 対称性をチェック:顔や物体の非対称な特徴を探す
- 背景を分析:AI生成の背景にはアーティファクトが含まれることが多い
- 文脈を確認:画像が論理的に意味をなしているか
- 検出ツールを使用:Detect AI Imageのようなツールを手動検査と併用して包括的な検証を行う
実用的な応用と業界への影響
ジャーナリズムとメディアの検証
ジャーナリストは、AI検出ツールを活用して以下を行います。
- ソーシャルメディア上のユーザー投稿コンテンツの検証
- 速報時の画像の真偽確認
- 政治やセンシティブな文脈におけるディープフェイクの特定
「偽情報が横行する時代において、本物とAI生成画像を見分けるツールは、ジャーナリズムの信頼性を維持するために不可欠です」と、グローバルニュースネットワークのデジタル編集者、サラ・チェンは述べています。
学術の健全性
教育機関はAI検出を利用して以下を行います。
- 学生のアートワーク提出物の検証
- 研究論文におけるAI生成画像の検出
- デジタルメディアコースでの学術的誠実性の維持
コンテンツ制作と著作権
コンテンツクリエイターやマーケターは、以下の点で恩恵を受けます。
- ストック画像の出所確認
- AI生成コンテンツの適切な帰属
- オリジナル作品を不正なAI学習から保護
AI画像生成と検出の未来
生成技術と検出技術の両方が進化するにつれ、以下のような展開が予想されます。
- より洗練されたモデル:将来のAI生成器はさらにリアルな画像を生成するようになる
- 検出技術の向上:Detect AI Imageのようなツールがアルゴリズムを強化し、進化に対応する
- 規制の発展:AI生成コンテンツのラベリング要件が導入される可能性
- ハイブリッドアプローチ:ディフュージョンモデルとGANの強みを組み合わせた手法
研究者たちは以下のような技術も探求しています。
- ウォーターマーキング技術:AI生成画像に目に見えないマーカーを埋め込む
- メタデータ標準:AIコンテンツ識別のためのプロトコル開発
- 協調的検出:AIアーティファクトを特定するためのコミュニティ主導のアプローチ
画像検証のためのベストプラクティス
- 複数の方法を組み合わせる:手動検査と自動ツールの両方を使用する
- 画像メタデータを確認:AI関連のメタデータや不整合を探す
- 逆画像検索:画像がオンライン上の他の場所に存在するか確認する
- 情報源を考慮:画像提供者の信頼性を評価する
- 専門ツールを活用:Detect AI Imageのようなプラットフォームを利用して包括的な分析を行う
- 最新情報を把握:AI画像生成技術の進歩に遅れないようにする
- 文脈分析:画像が論理的に意味をなしているかを考慮する
結論
ディフュージョンモデルとGANはどちらも印象的なAI生成コンテンツを作り出しますが、その根底にあるメカニズムにより、出力には明確な特徴の違いがあります。ディフュージョンモデルは一般的に高品質で多様な画像を提供しますが、より多くの計算リソースを必要とします。一方、GANは高速な生成を実現しますが、出力品質や多様性において妥協が生じる可能性があります。
ジャーナリズム、教育、コンテンツ制作の専門家にとって、これらの違いを理解することは、効果的な画像検証に不可欠です。Detect AI Imageのようなツールは、異なるAI生成技術が残す微細なアーティファクトを特定することで、デジタルコンテンツの真正性を維持する上で重要な役割を果たします。
AI画像生成技術が進化し続ける中で、これらの技術とその検出方法についての知識を常に更新していくことは、デジタル画像を扱うすべての人にとって不可欠です。ニュース写真の検証、学生の提出物の評価、オリジナルコンテンツの制作など、本物とAI生成画像を見分ける能力は、デジタル時代における重要なスキルであり続けるでしょう。